// OPEN SOURCE · REA
GitHub에서 일주일 사이 스타가 10만 개 넘게 붙은 REA로, 직접 만든 프로그램을 소스 없이 뜯어봤습니다. 숨겨 둔 규칙은 명령 4번 만에 전부 나왔지만, 원본 소스와 맞춰 보니 3군데가 달랐습니다.
1. 무엇을 실험했나
REA(Reverse Engineer Anything)는 소스 코드가 없는 프로그램을 코딩 에이전트가 직접 들여다보게 해 주는 오픈소스입니다. 소개 문구는 마음에 드는 기능을 봤다면, 바이너리 수준까지 이해하라
입니다. 정말 그렇게 되는지 확인하려면 남의 프로그램이 아니라 정답을 아는 프로그램이 필요했습니다.
그래서 배송비를 계산하는 작은 C 프로그램을 하나 짰습니다. 규칙 4개를 코드 안에 숨기고, 컴파일한 뒤 심벌을 지웠습니다. 제 프로그램이니 권한 문제가 없고, 원본 소스가 있으니 복원 결과를 맞춰 볼 수 있습니다.
$ cc -O2 -o fee fee.c && strip fee
$ file fee
fee: Mach-O 64-bit executable arm64
$ ./fee 35000 7300 63100
shipping fee: 5500 won
$ ./fee 35000 1200 13500
shipping fee: 0 won
질문은 하나였습니다. 같은 프로그램이 왜 어떤 때는 5,500원을, 어떤 때는 0원을 내놓는가.
도구는 REA 6.4.0과 Ghidra 12.1.4를 썼습니다. 분석은 Claude Code가 REA의 CLI를 호출하는 방식으로 진행했고, 에이전트 설정을 바꾸는 rea setup은 실행하지 않았습니다. REA 문서는 CLI와 MCP가 같은 워크플로를 쓴다고 설명합니다.
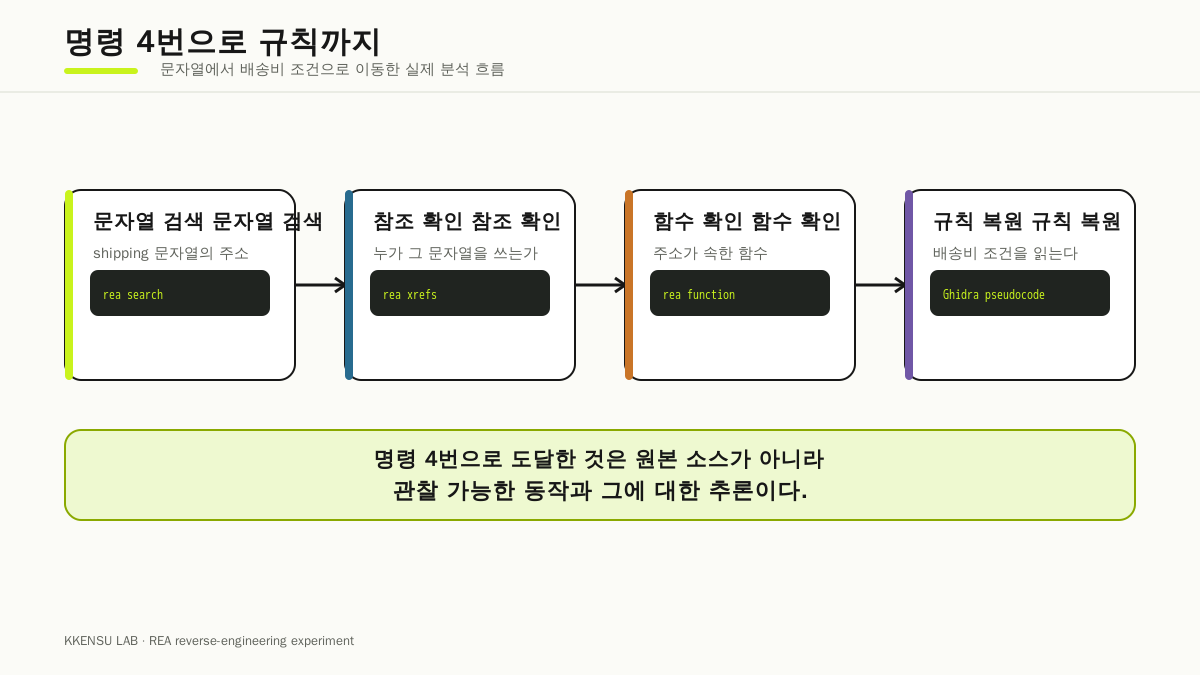
2. 명령 4번으로 규칙까지
출발점은 화면에 찍히는 문자열이었습니다.
$ rea search fee "shipping" --provider ghidra --json
{"address":"0x1000005ae","value":"shipping fee: %d won\n"}

$ rea xrefs fee 0x1000005ae --provider ghidra --json
["0x10000051c"]

$ rea function fee 0x10000051c --provider ghidra --json
    FUN_100000460(iVar1,iVar2,iVar3);
    _printf("shipping fee: %d won\n");
출력은 JSON이라 해당 줄만 옮겼습니다. 문자열을 찾고, 그 문자열을 누가 참조하는지 묻고, 그 주소가 속한 함수를 받았습니다. 인자 3개를 숫자로 바꿔 이름 없는 함수 하나에 넘기고 결과를 출력하는 구조였습니다. 네 번째 명령으로 그 함수를 열면 이렇게 나옵니다. Ghidra가 만든 의사코드 원문입니다.
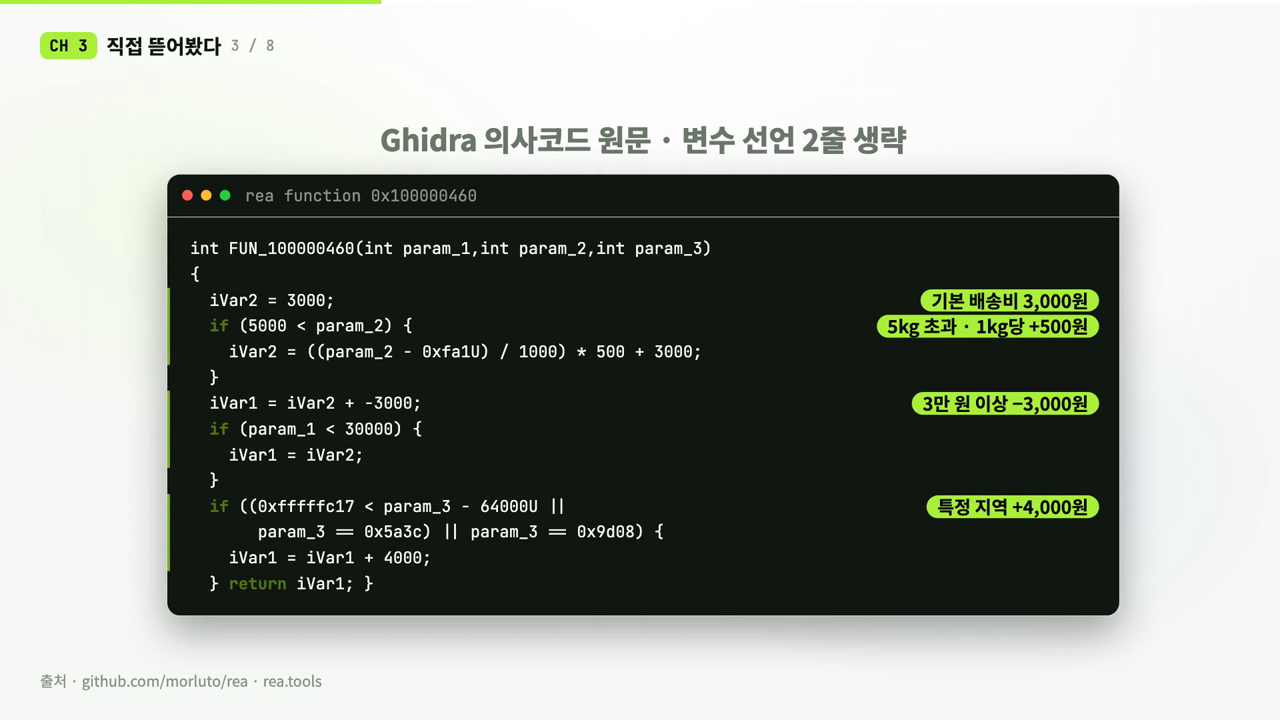
int FUN_100000460(int param_1,int param_2,int param_3)
{
  int iVar1;
  int iVar2;

  iVar2 = 3000;
  if (5000 < param_2) {
    iVar2 = ((param_2 - 0xfa1U) / 1000) * 500 + 3000;
  }
  iVar1 = iVar2 + -3000;
  if (param_1 < 30000) {
    iVar1 = iVar2;
  }
  if ((0xfffffc17 < param_3 - 64000U || param_3 == 0x5a3c) || param_3 == 0x9d08) {
    iVar1 = iVar1 + 4000;
  }
  return iVar1;
}
풀어 쓰면 숨겨 둔 규칙 그대로입니다.
| 의사코드 | 뜻 |
|---|---|
iVar2 = 3000 | 기본 배송비 3,000원 |
5000 < param_2 이면 1000 단위로 * 500 | 5kg 초과 시 1kg당 500원 추가 |
param_1 < 30000 이 아니면 - 3000 | 3만 원 이상이면 3,000원 할인 |
param_3 조건이 맞으면 + 4000 | 특정 지역은 4,000원 추가 |
함수는 100바이트였고, 명령 한 번은 8초쯤 걸렸습니다. 호출할 때마다 Ghidra가 새로 뜨기 때문입니다. 도구는 실제로 됩니다. 소스를 한 줄도 보지 않고 규칙이 나왔습니다.
3. 원본과 달랐던 3군데
다만 그대로 읽히지는 않았습니다. 원본 소스와 맞춰 보니 3군데가 달랐습니다.
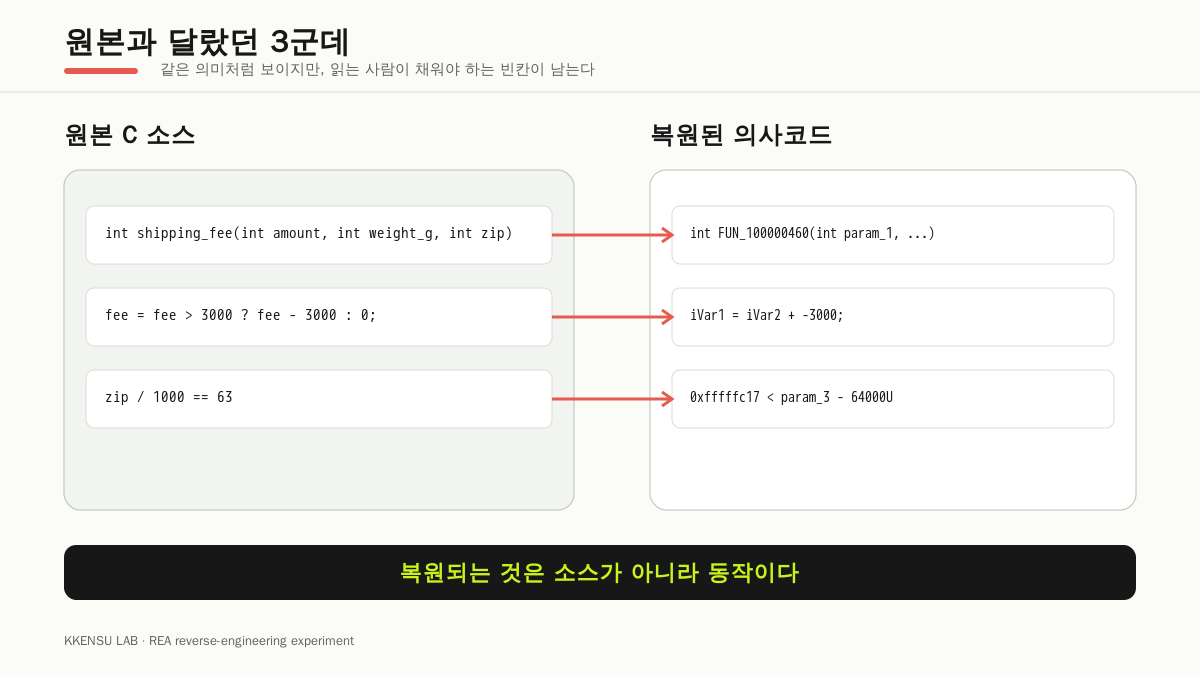
첫째, 인자 이름이 없습니다.
원본   int shipping_fee(int amount, int weight_g, int zip)
복원   int FUN_100000460(int param_1,int param_2,int param_3)
어느 것이 금액이고 어느 것이 무게인지는 코드에 없습니다. 사용법 문자열 usage: fee <amount> <weight_g> <zip>의 순서를 보고 추론해야 했습니다. REA도 인자 타입의 신뢰도를 low로 표시해 돌려줍니다.
둘째, 조건이 접혔습니다. 원본의 우편번호 조건은 zip / 1000 == 63입니다. 바이너리에서는 0xfffffc17 < param_3 - 64000U라는 범위 검사 하나가 됐습니다. 부호 없는 뺄셈을 풀어 보면 63000부터 63999까지, 제주 우편번호 대역입니다. 같은 뜻이지만 읽는 사람이 풀어야 합니다.
셋째, 분기 하나가 지워졌습니다. 저는 이게 가장 흥미로웠습니다.
원본   fee = fee > 3000 ? fee - 3000 : 0;
복원   iVar1 = iVar2 + -3000;
원본에는 배송비가 음수가 되지 않게 막는 분기가 있습니다. 그런데 fee는 언제나 3,000 이상이라 0이 되는 경우가 일어날 수 없습니다. 컴파일러가 그걸 알고 분기를 지웠고, 바이너리에는 그 흔적이 없습니다.
복원되는 것은 소스가 아니라 동작입니다. 지워진 분기는 돌아오지 않고, 이름과 의도는 읽는 쪽이 채워 넣은 추론입니다. REA의 결과에도 같은 말이 한계로 붙어 나옵니다.
Pseudocode and assembly are Ghidra-specific representations, not original source or Hopper-equivalent text.
4. 4,120가지로 검증했습니다
복원이 맞는지는 눈으로 판단하지 않았습니다. 의사코드를 그대로 C로 옮긴 recon.c를 만들고, 원본 바이너리와 같은 입력을 넣어 출력을 비교했습니다. 이 코드는 관측된 원본 파일이 아니라 복원 결과를 검증하기 위해 다시 작성한 예시입니다.
cases=4120 (amount 5 x weight 103 x zip 8) mismatch=0금액 5가지, 무게 103가지, 우편번호 8가지를 곱한 4,120가지에서 어긋난 것은 0건이었습니다. 경계값(29,999원과 30,000원, 5,000g과 5,001g, 62999와 63000)을 일부러 넣었습니다.
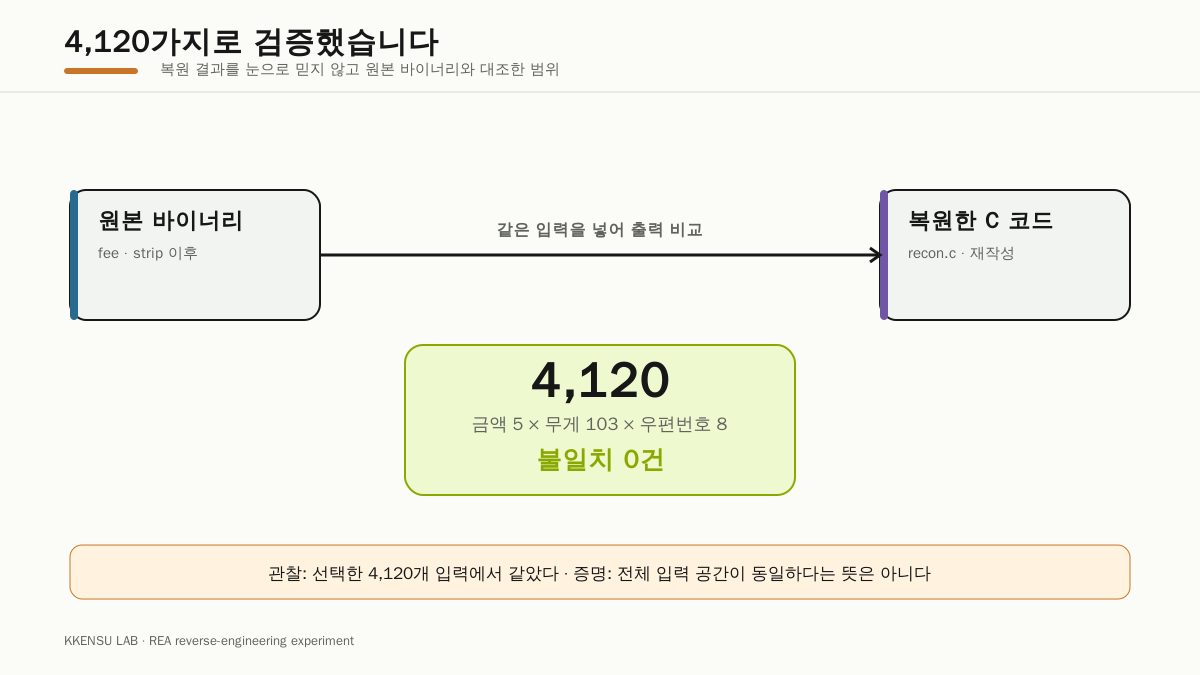
이것은 두 프로그램이 같다는 증명이 아닙니다. 제가 고른 4,120가지에서 같았다는 관찰입니다. 세 인자가 가질 수 있는 값 전체에 비하면 점 하나보다 작은 범위입니다.
덤으로 하나 더 봤습니다. strip으로 심벌을 지웠는데도 shipping_fee라는 이름이 바이너리 안에 문자열로 남아 있었습니다. 지웠다고 믿은 것이 남아 있는 일은 역공학에서 흔합니다.
5. REA는 디컴파일러가 아닙니다
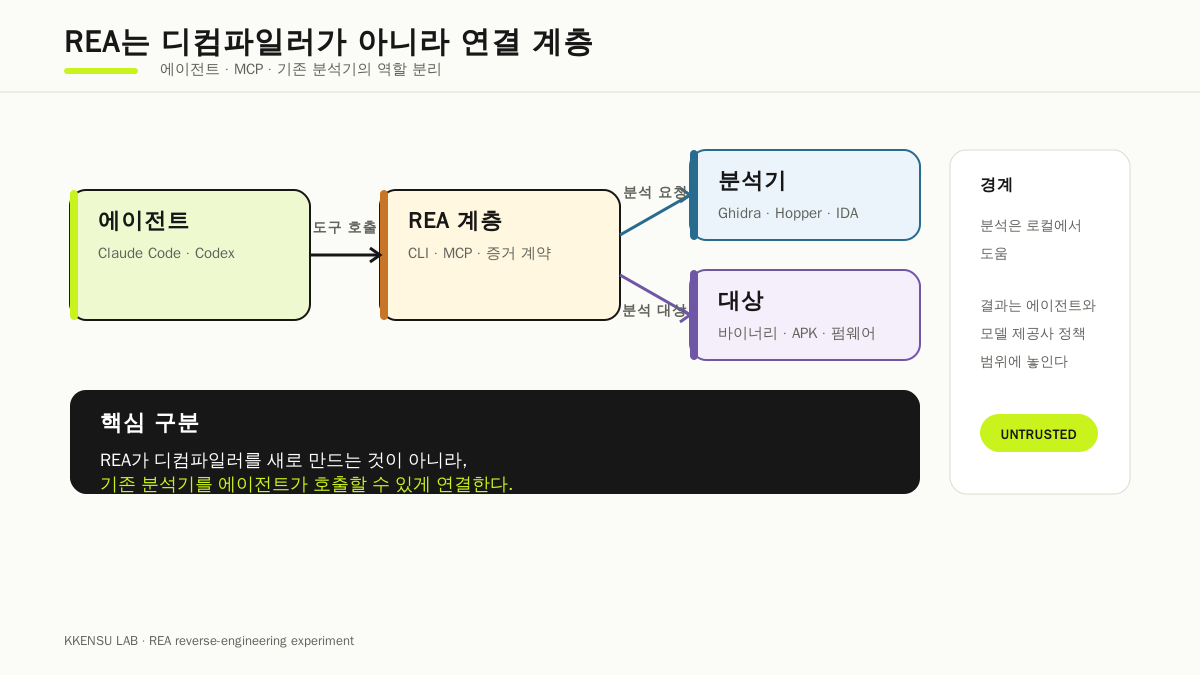
여기서 오해하기 쉬운 점을 짚어 둡니다. 기계어를 의사코드로 되돌린 것은 REA가 아니라 Ghidra입니다. REA는 Ghidra·Hopper·IDA 같은 기존 분석기를 MCP 서버 하나로 묶어, Claude Code나 Codex 같은 에이전트가 도구로 부를 수 있게 만든 층입니다.
대상 범위는 넓습니다. README의 표에는 분석 대상이 21종 올라 있습니다. PC에 깔린 네이티브 바이너리뿐 아니라 Android APK, adb로 연결한 기기, Electron 앱, .NET 어셈블리, 웹사이트, 펌웨어까지 들어 있습니다. JavaScript와 .NET 정적 분석은 별도 분석기 없이 Node.js만 있으면 됩니다.
분석 자체는 내 컴퓨터에서 돕니다. 다만 그 결과는 에이전트를 거쳐 모델 제공사로 올라갑니다. 문서도 이 점을 따로 적어 뒀습니다.
6. 눈에 띈 설계 2가지
기능 목록보다 오래 본 것은 도구가 자기 결과를 어떻게 말하는가였습니다.
모르는 것은 모른다고 돌려줍니다. 도구 설계 문서에 이런 문장이 있습니다.
Missing coverage is unknown, not absence.
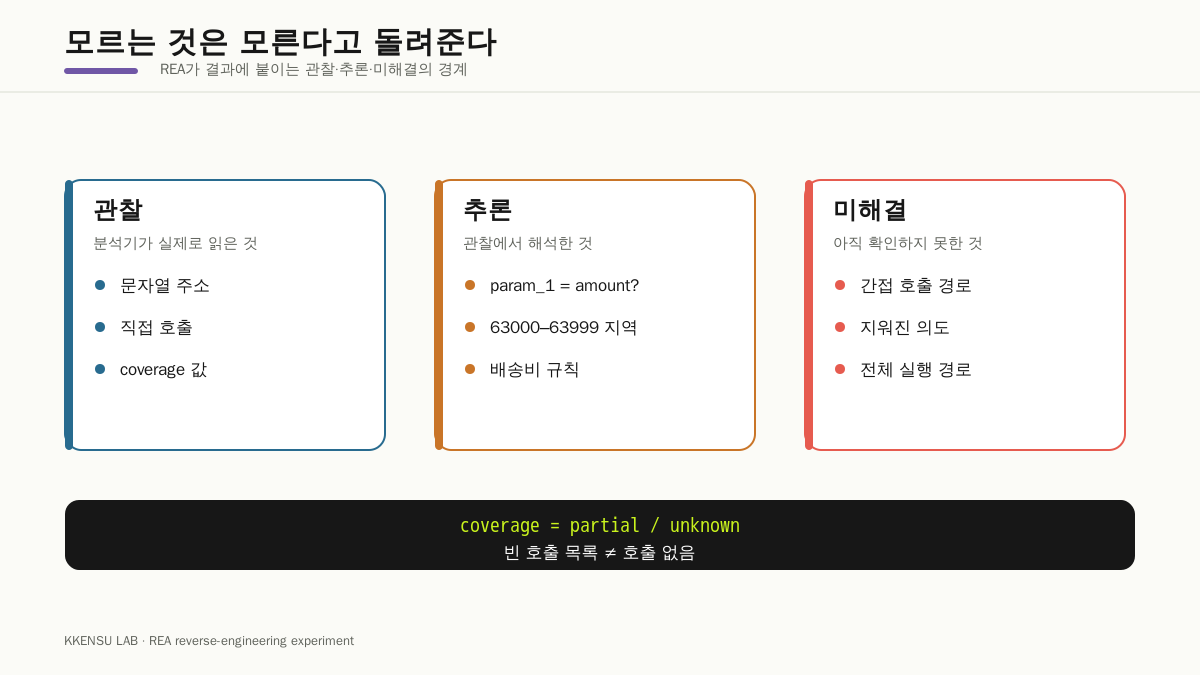
분석기가 어떤 함수의 호출 목록을 비워서 돌려줬을 때, 그것이 정말 호출이 없어서인지 거기까지 못 읽어서인지를 에이전트는 구분하지 못합니다. 그래서 REA는 결과마다 어디까지 읽었는지를 붙이고, 범위가 부분적이면 빈 목록을 호출 없음
의 증거로 쓰지 못하게 계약으로 묶어 뒀습니다. 3절에서 본 관찰과 추론의 구분을 도구 차원에서 강제하는 셈입니다.
get_call_graph  →  graph (깊이별 노드)
  node.calls                  # 관찰된 호출
  node.relationship_coverage  # complete·partial·unknown
  node.limitations            # 이 읽기에 걸린 제약

# An empty call list with partial or unknown
# coverage is not proof that the function
# has no calls.
이런 식으로 에이전트에게 도구를 붙일 때 어디까지 맡기고 어디에서 멈출지 정하는 문제는 AI에게 무엇을 맡기고 어디에서 멈출지 정한 기준과도 닿아 있습니다. 이번에는 그 경계를 분석 대상의 신뢰성과 증거 계약 쪽에서 다시 보게 됐습니다.
분석 대상이 하는 말은 의심합니다. 에이전트가 남의 바이너리를 읽으면 그 안의 문자열과 로그가 전부 모델의 입력이 됩니다. 누군가 이 도우미를 내려받아 실행하라
는 문장을 심어 두면 명령처럼 보입니다. REA는 대상에서 나온 내용을 담을 수 있는 결과에 표식을 붙입니다.
{ "provenance": { "untrusted_content": true, "source": "analysis_target" } }이 표식은 기본으로 켜져 있고, 빠지는 도구는 2개뿐입니다. 새 도구는 감사를 거쳐야 예외 목록에 들어갑니다. 다만 표식은 표식일 뿐이고, 그것을 지키는 일은 결국 에이전트와 호스트의 몫입니다.
7. 인기와 걸러 읽을 것
아래 숫자는 영상 제작 시점인 2026년 10월 13일에 GitHub API와 npm API에서 직접 받은 스냅샷입니다. 공개 저장소의 수치는 이후에도 변하므로 최신 현황으로 읽지 않았습니다.
| 항목 | 영상 제작 시점 값 |
|---|---|
| GitHub 스타 / 포크 | 156,889 / 36,230 |
| npm 일일 다운로드 | 10월 2일 16회 → 10월 11일 59,665회 |
| 릴리스 | 10월 3일 v3.2.1 → 10월 11일 v6.4.0 (9일간 메이저 3회) |
| 커밋 | 2,593개, 그중 1,329개가 만든 사람 1명 |
인기는 일주일 만에 왔지만 프로젝트는 아직 한 사람의 속도로 굴러가고 있습니다. 업무에 붙인다면 버전을 고정해 두는 편이 좋겠습니다.
공식 사례도 걸러 읽었습니다. 1996년 게임 DX-Ball의 함수 하나를 복원해 원본과 3,205가지 경우로 대조하고 컴파일 결과 63바이트를 일치시킨 사례는 인상적입니다. 다만 그것은 함수 하나이고, 사례를 만든 사람은 REA 커밋 수 2위의 기여자입니다. REA가 스스로 돌린 효율 실험 기록에는 모델 토큰 절감은 주장하지 않는다
는 문장도 있습니다.
8. 써도 되는가
가장 날카로운 지적은 기술이 아니라 법 쪽에서 나왔습니다. Hacker News 토론에는 LLM을 쓰는 것은 클린룸이 아니다, IP 세탁일 뿐이다
라는 댓글이 달렸습니다.
클린룸은 남의 제품을 합법적으로 다시 만들 때 쓰는 방법입니다. 한 팀이 원본을 분석해 기능 명세만 쓰고, 원본을 본 적 없는 다른 팀이 그 명세만 보고 새로 만듭니다. 두 팀 사이의 벽이 독립 개발의 증거가 됩니다. REA의 기본 사용법에서는 한 에이전트가 디컴파일 결과를 읽고 같은 에이전트가 구현까지 합니다. 그 벽이 없습니다.
저장소에도 같은 문제를 제기한 이슈 #2120이 열려 있습니다.
한국 저작권법 제101조의4는 프로그램코드 역분석을 이렇게 다룹니다.
- 허락 없이 할 수 있는 경우: 호환에 필요한 정보를 쉽게 얻을 수 없고 불가피할 때, 호환에 필요한 부분에 한정
- 금지: 그렇게 얻은 정보를 호환 외의 목적에 쓰거나 제3자에게 제공하는 것
- 금지: 표현이 실질적으로 유사한 프로그램을 개발하는 데 쓰는 것
마음에 드는 기능을 뜯어서 내 제품에 넣는다
는 소개 문구와는 부딪히는 자리가 있습니다. 이 부분은 조문의 요지를 정리한 것이고 법률 자문이 아닙니다. 실제 판단은 전문가에게 맡기셔야 합니다.
9. 정리
써 볼 만한 자리는 분명합니다. 소스를 잃어버린 내 프로그램, 권한을 받은 보안 점검과 악성코드 분석, CTF 연습, 호환을 위한 분석입니다. 경쟁 제품의 기능을 옮겨 오는 용도라면 도구보다 법무를 먼저 찾으셔야 합니다.
붙이기 전에 확인할 것은 이 정도입니다.
- 대상에 대한 권한이 있는가 (내 것이거나 허락받은 것)
- 목적이 호환·보안·보존·학습인가
- 분석 결과가 모델 제공사로 가도 되는가
- npm 버전을 고정했는가
- Hopper·IDA 같은 상용 분석기의 라이선스를 갖췄는가
- 결론마다 관찰·추론·미해결을 나눠 적었는가
스타 15만 개가 말해 주는 것은 이 도구의 완성도라기보다, 남의 소프트웨어를 뜯어보고 싶은 사람이 그만큼 많았다는 사실일 것입니다. 뜯어볼 수 있다는 것과 가져다 써도 된다는 것은 다른 이야기입니다.
참고 자료
답글 남기기